DEEP LEARNING · CONVOLUTIONAL NEURAL NETWORKS

Redes Neuronales
Convolucionales CNN

Las Redes Neuronales Convolucionales (CNN, por sus siglas en inglés: Convolutional Neural Networks) son arquitecturas especializadas de Deep Learning diseñadas para analizar, interpretar y extraer características relevantes de información visual, principalmente imágenes y secuencias de video. Estas redes permiten desarrollar modelos capaces de reconocer patrones, identificar objetos, clasificar imágenes y detectar elementos visuales mediante operaciones de aprendizaje automático.

Redes Neuronales Convolucionales CNN - Deep Learning
ANÁLISIS VISUAL CNN
ARQUITECTURA CNN

¿Cómo funcionan las redes neuronales convolucionales?

El funcionamiento de una CNN se basa en una arquitectura compuesta por múltiples capas neuronales especializadas que transforman progresivamente la información visual en representaciones matemáticas utilizadas para realizar tareas de reconocimiento, detección y clasificación.

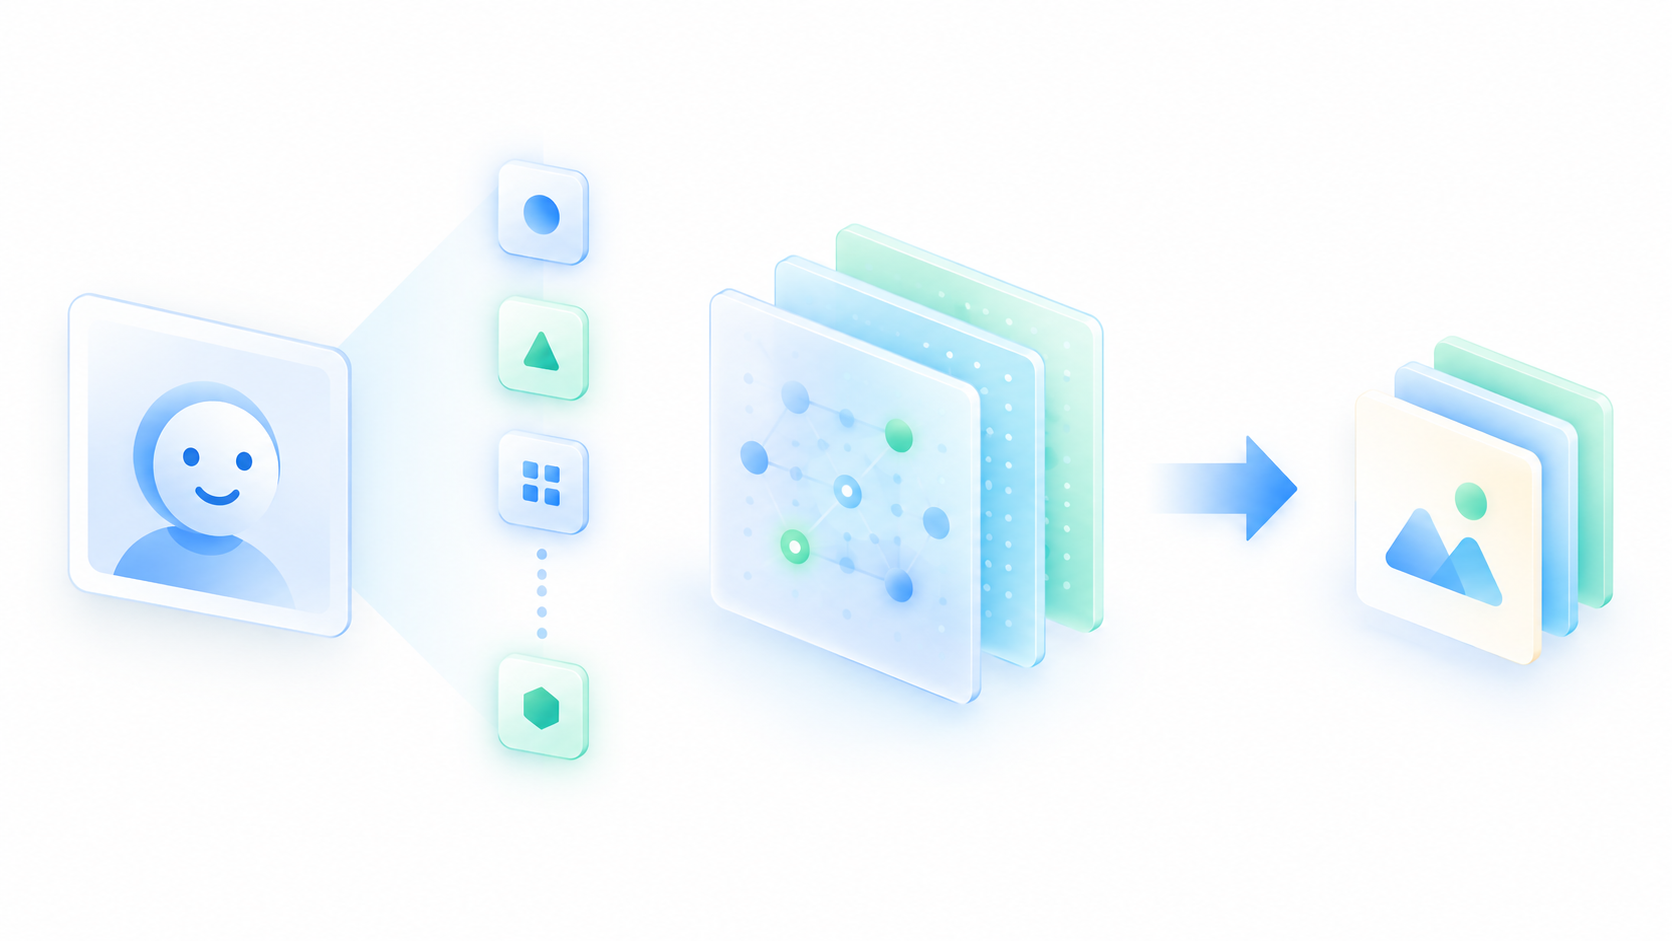
Cuando una imagen ingresa al modelo, se representa como una matriz multidimensional de valores numéricos correspondientes a sus píxeles y canales de color. A partir de esta información, la red aplica operaciones matemáticas para identificar patrones espaciales y relaciones entre los elementos presentes en la imagen.

Las primeras capas de una CNN suelen detectar características visuales de bajo nivel, como bordes, líneas, texturas y contornos. Las capas posteriores combinan estas características para construir representaciones de mayor complejidad, permitiendo reconocer estructuras, objetos y categorías visuales.

Este mecanismo permite que un modelo entrenado pueda reconocer patrones visuales incluso cuando existen variaciones de iluminación, escala, orientación o posición, siempre que dichas variaciones estén adecuadamente representadas durante el proceso de entrenamiento.
COMPONENTES CNN

Arquitectura y componentes principales de una CNN

Las Redes Neuronales Convolucionales combinan diferentes tipos de capas especializadas para extraer características visuales, reducir la complejidad de la información y generar resultados de clasificación, reconocimiento o detección.

Capas Convolucionales

Las capas convolucionales aplican filtros o kernels sobre regiones de una imagen o sobre mapas de características generados por capas anteriores. Su función es identificar patrones visuales como bordes, texturas, formas y estructuras relevantes.

Funciones de Activación

Las funciones de activación incorporan comportamiento no lineal dentro de la red neuronal, permitiendo que el modelo aprenda relaciones complejas entre los datos. Una de las más utilizadas es ReLU, que conserva valores positivos y transforma valores negativos en cero.

Capas de Agrupamiento

Las capas de agrupamiento o Pooling reducen las dimensiones espaciales de los mapas de características, conservando información relevante para las siguientes etapas del modelo. Una técnica habitual es Max Pooling, que selecciona el valor máximo dentro de pequeñas regiones.

Clasificación y Resultados

Después de la extracción de características, una CNN puede incorporar capas densamente conectadas, mecanismos de agrupamiento global u otras arquitecturas de salida para generar puntuaciones, probabilidades o categorías asociadas a la información analizada.