Secuencia JPEG
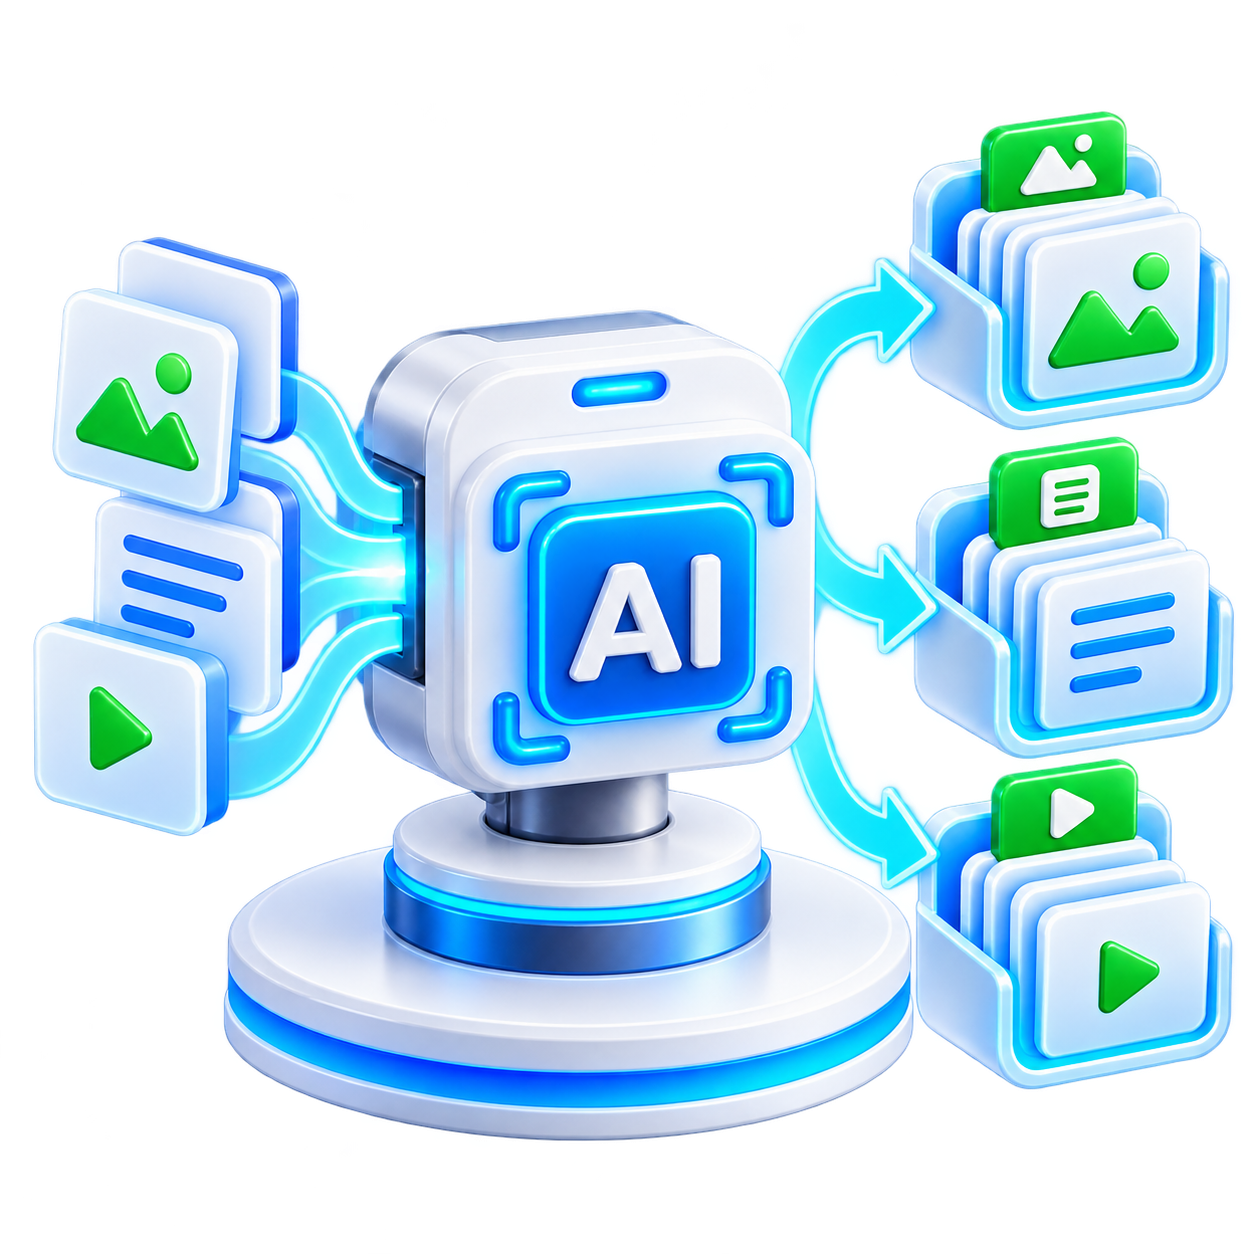
Generar desde cualquier fuente multimedia grandes volúmenes de frames JPEG para generar modelos de entrenamiento y ser analizadas por Operator Red Learning.
 Solicitar información →
Inteligencia visual para detectar, clasificar y localizar elementos específicos dentro de grandes secuencias de imágenes. Redav Vision Pixel utiliza el algoritmo de redes convolucionales y poder entrenar una Operator Red que tenga la capacidad de reconocer objetos dentro de una secuencia de imagenes y transformar contenido visual en información estructurada, medible y accionable.
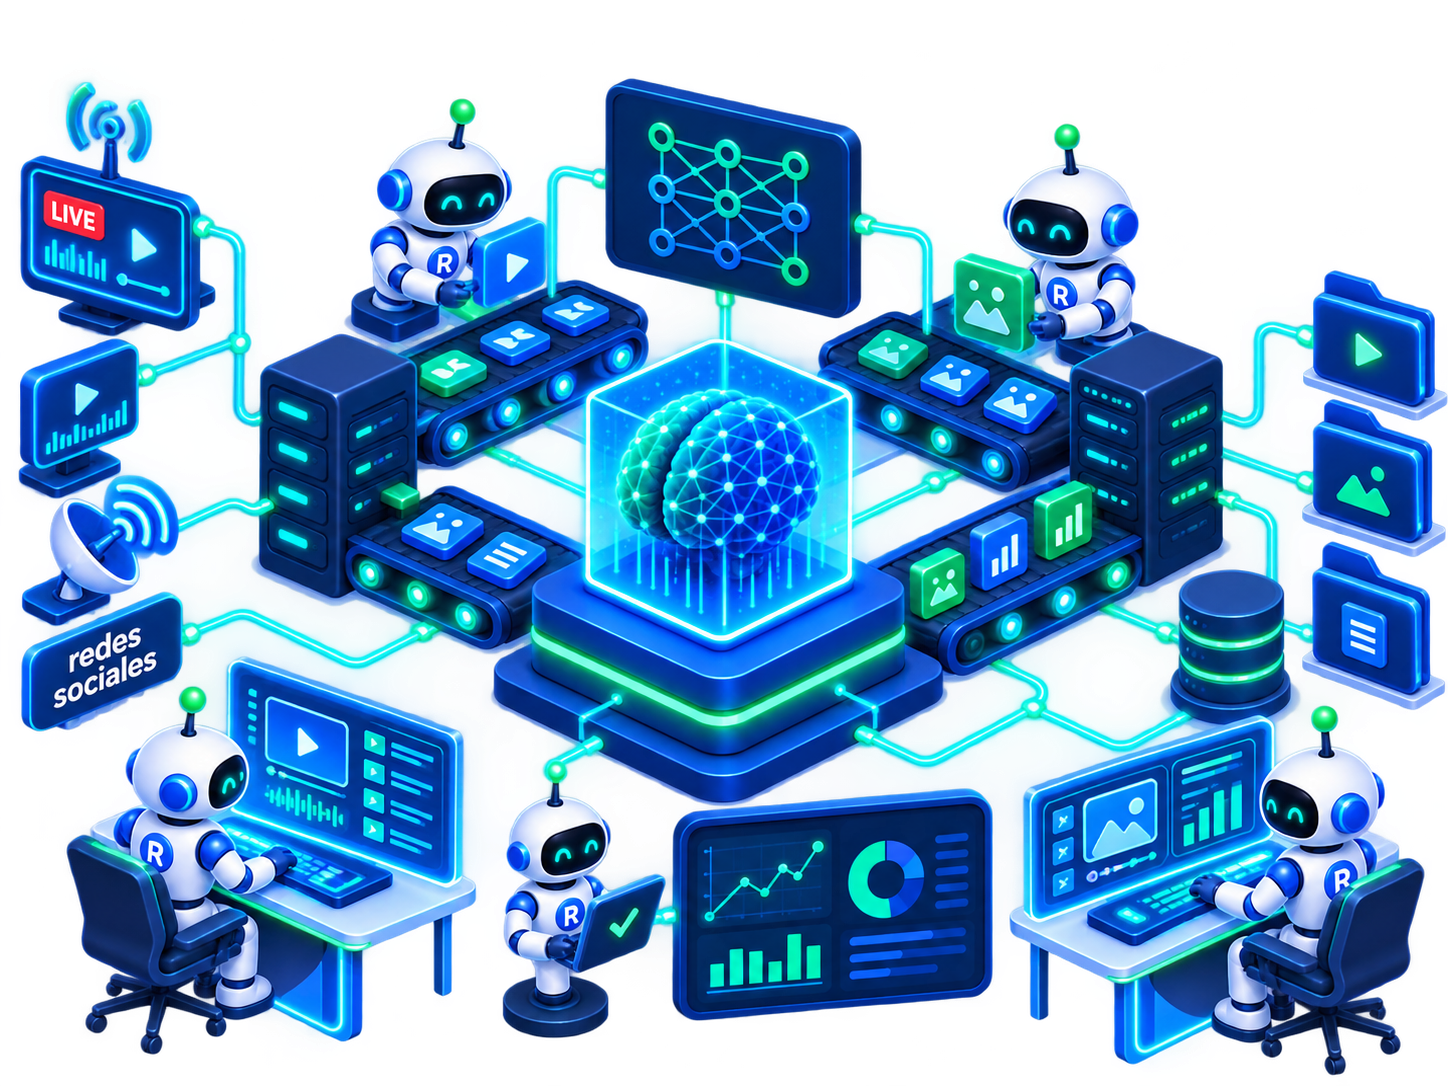
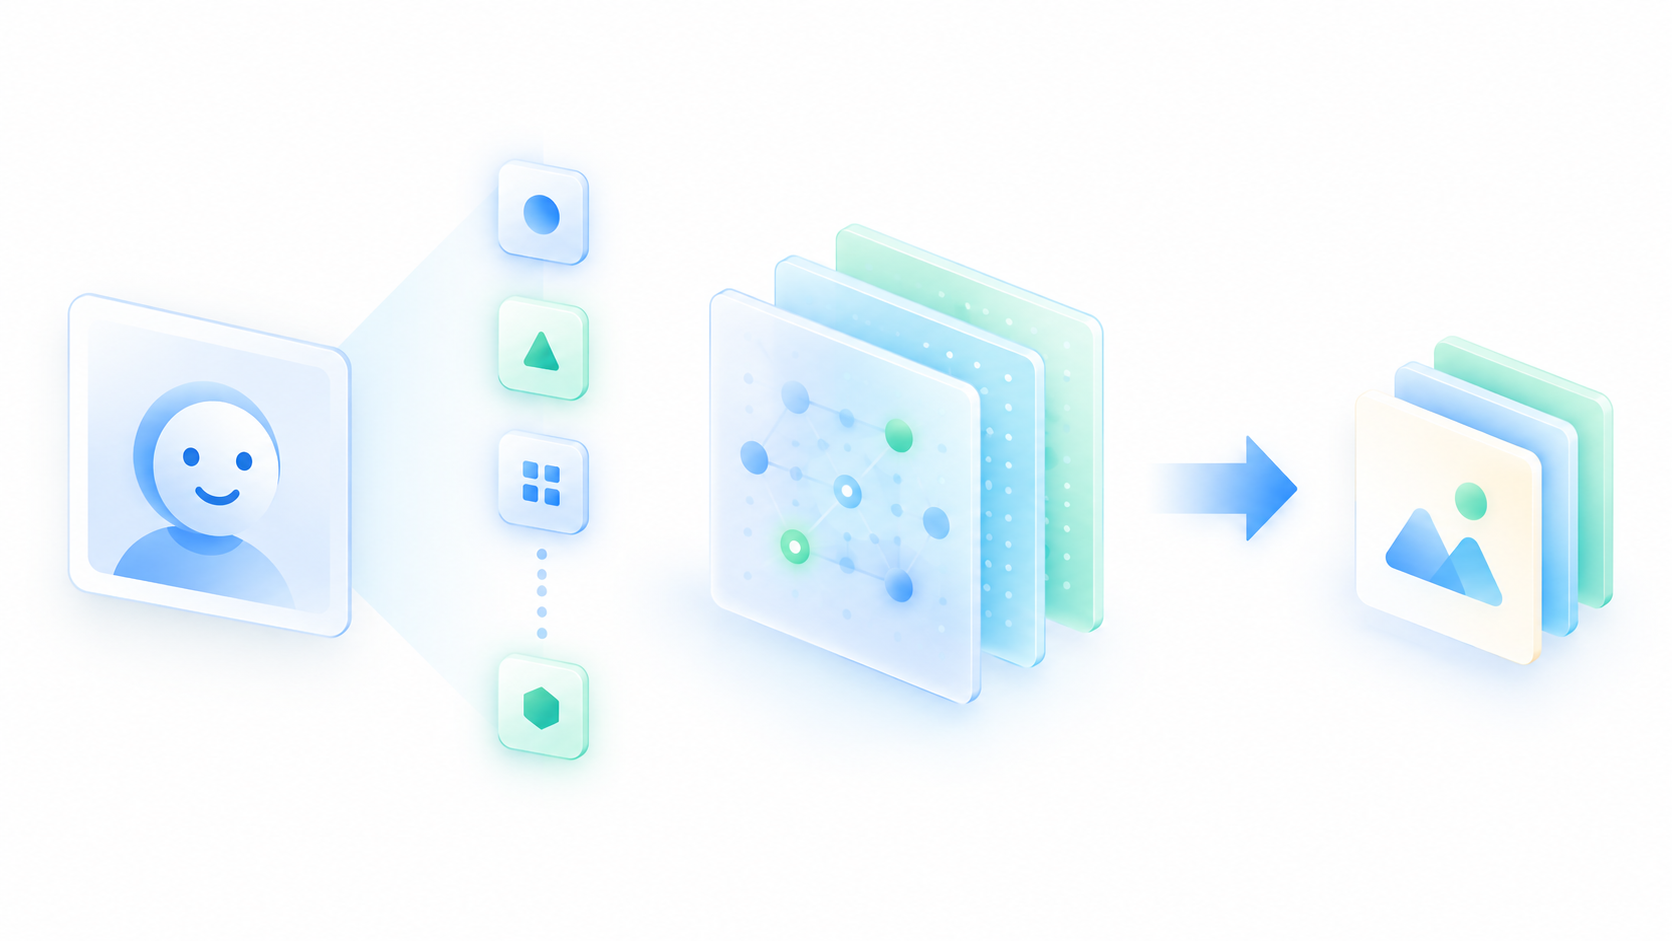
Modelos de entrenamiento son capaces de aprender patrones visuales complejos, representan una arquitectura avanzada dentro de la redes neuronales que permite identificar y clasificar elementos específicos a partir de secuencias de imágenes.
Mediante CNNs y arquitecturas especializadas, Redav Vision Pixel analiza información visual para detectar objetos, eventos y patrones previamente definidos. Los modelos aprenden automáticamente las características relevantes de cada clase y pueden mejorar progresivamente mediante nuevos ciclos de entrenamiento.
Este enfoque aprovecha la capacidad moderna de cómputo, almacenamiento e identificación paralelo para trabajar con grandes volúmenes de datos distribuidos en múltiples capas interconectadas, permitiendo extraer representaciones visuales complejas con alta precisión.
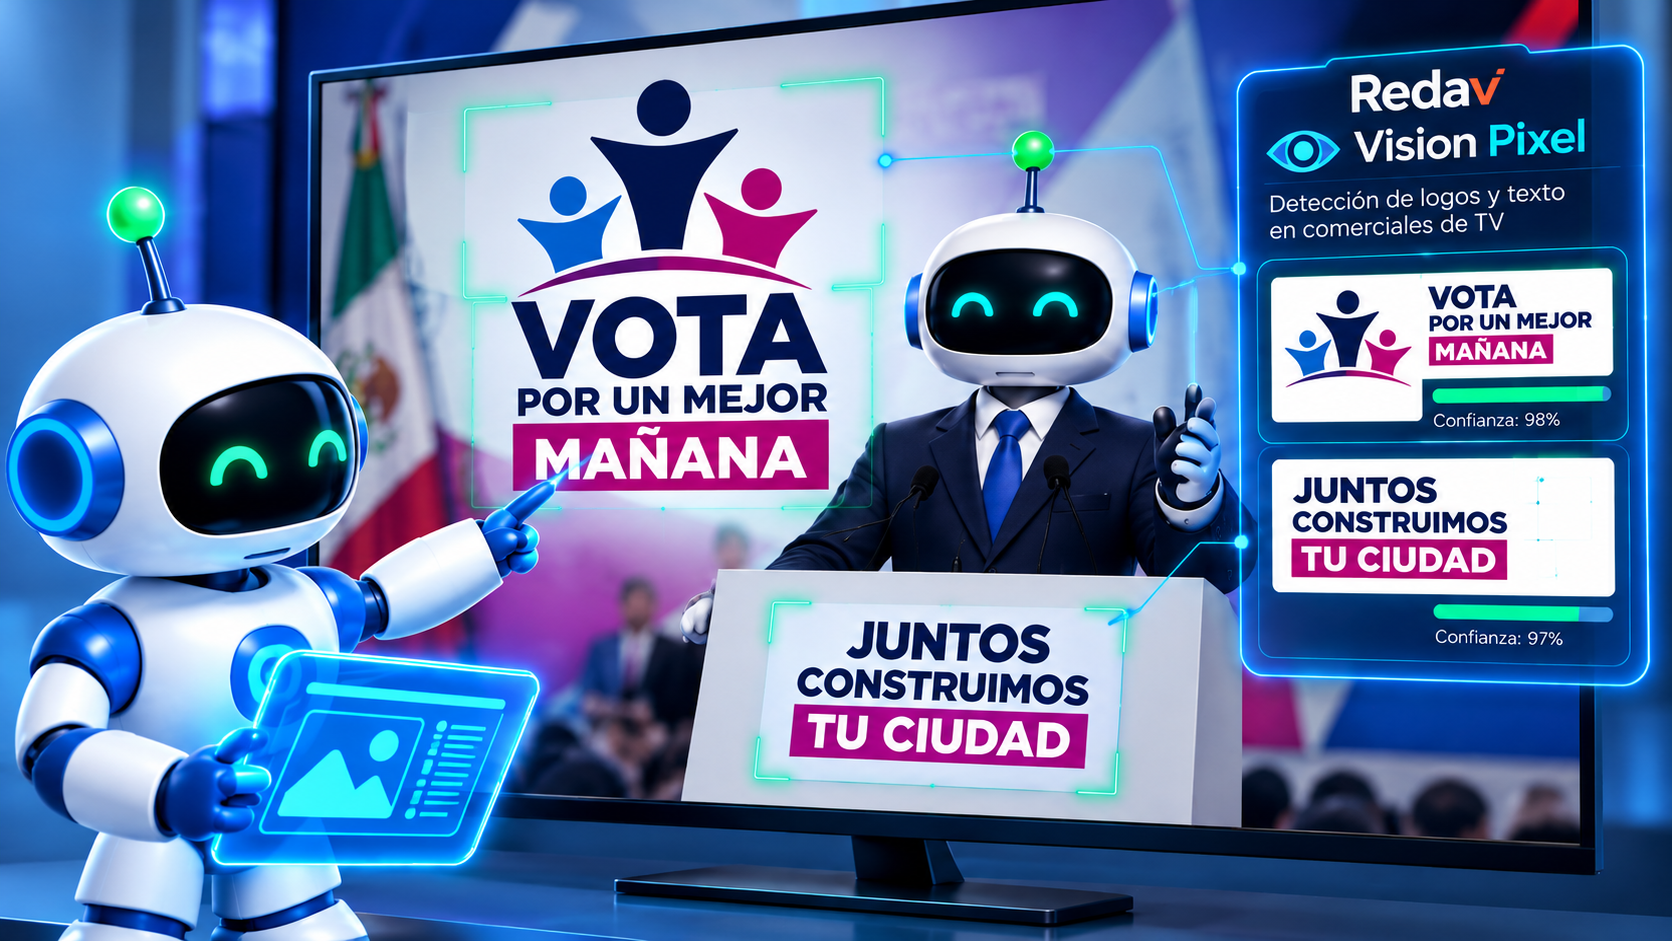
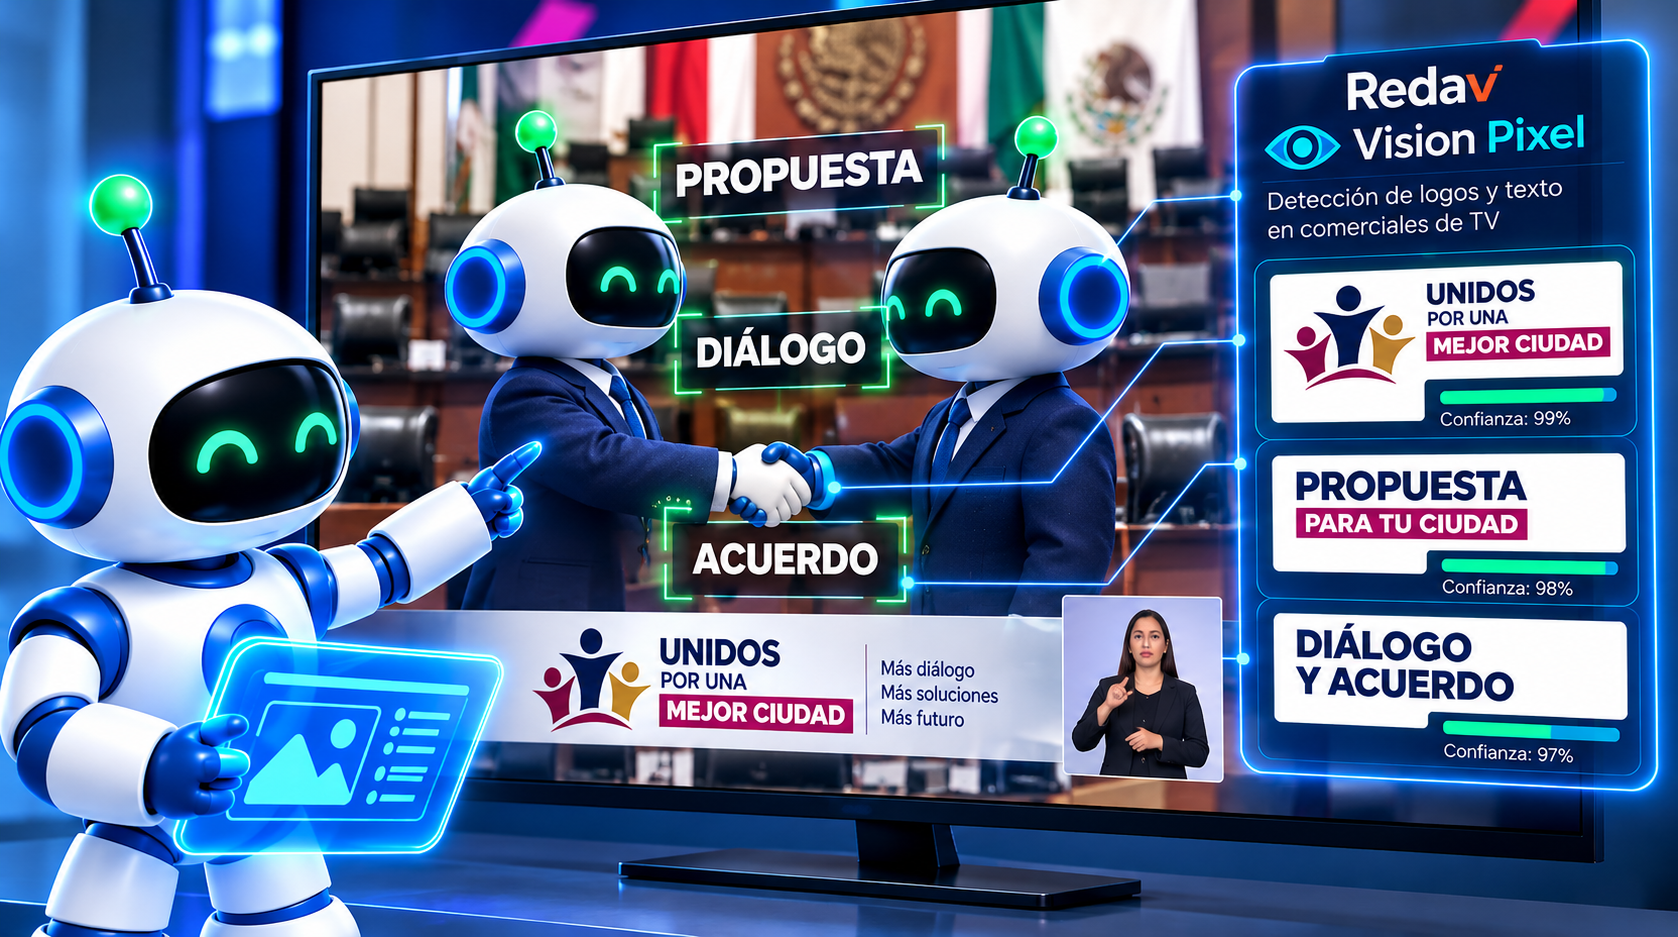
Representación conceptual del flujo de análisis de Redav Vision Pixel.
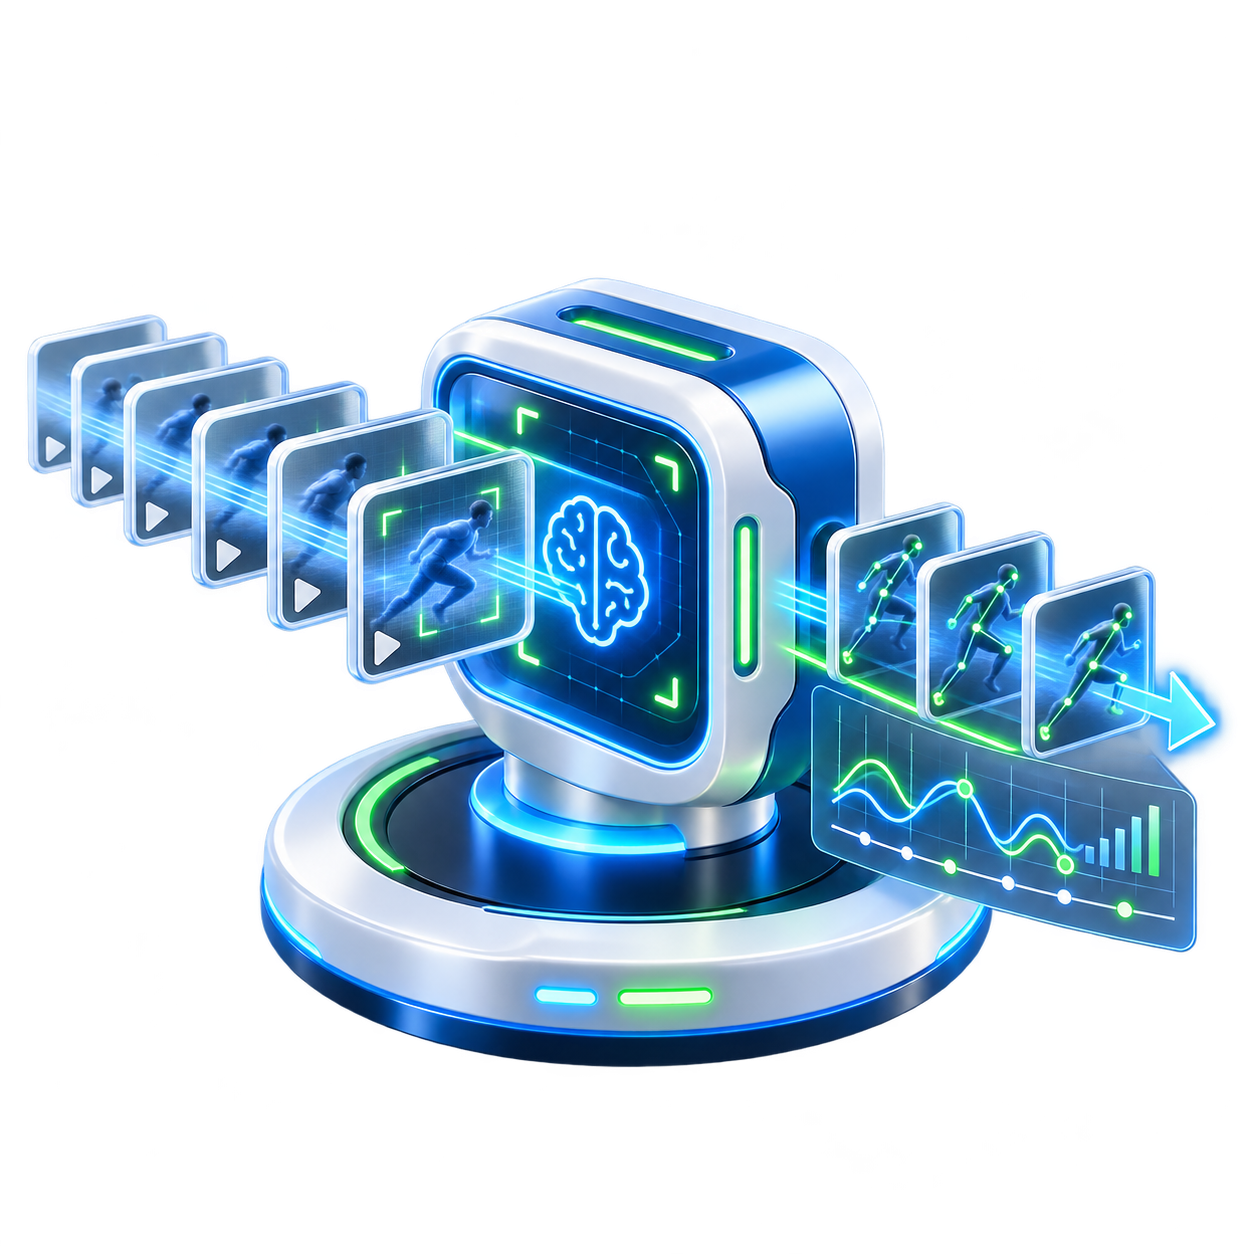
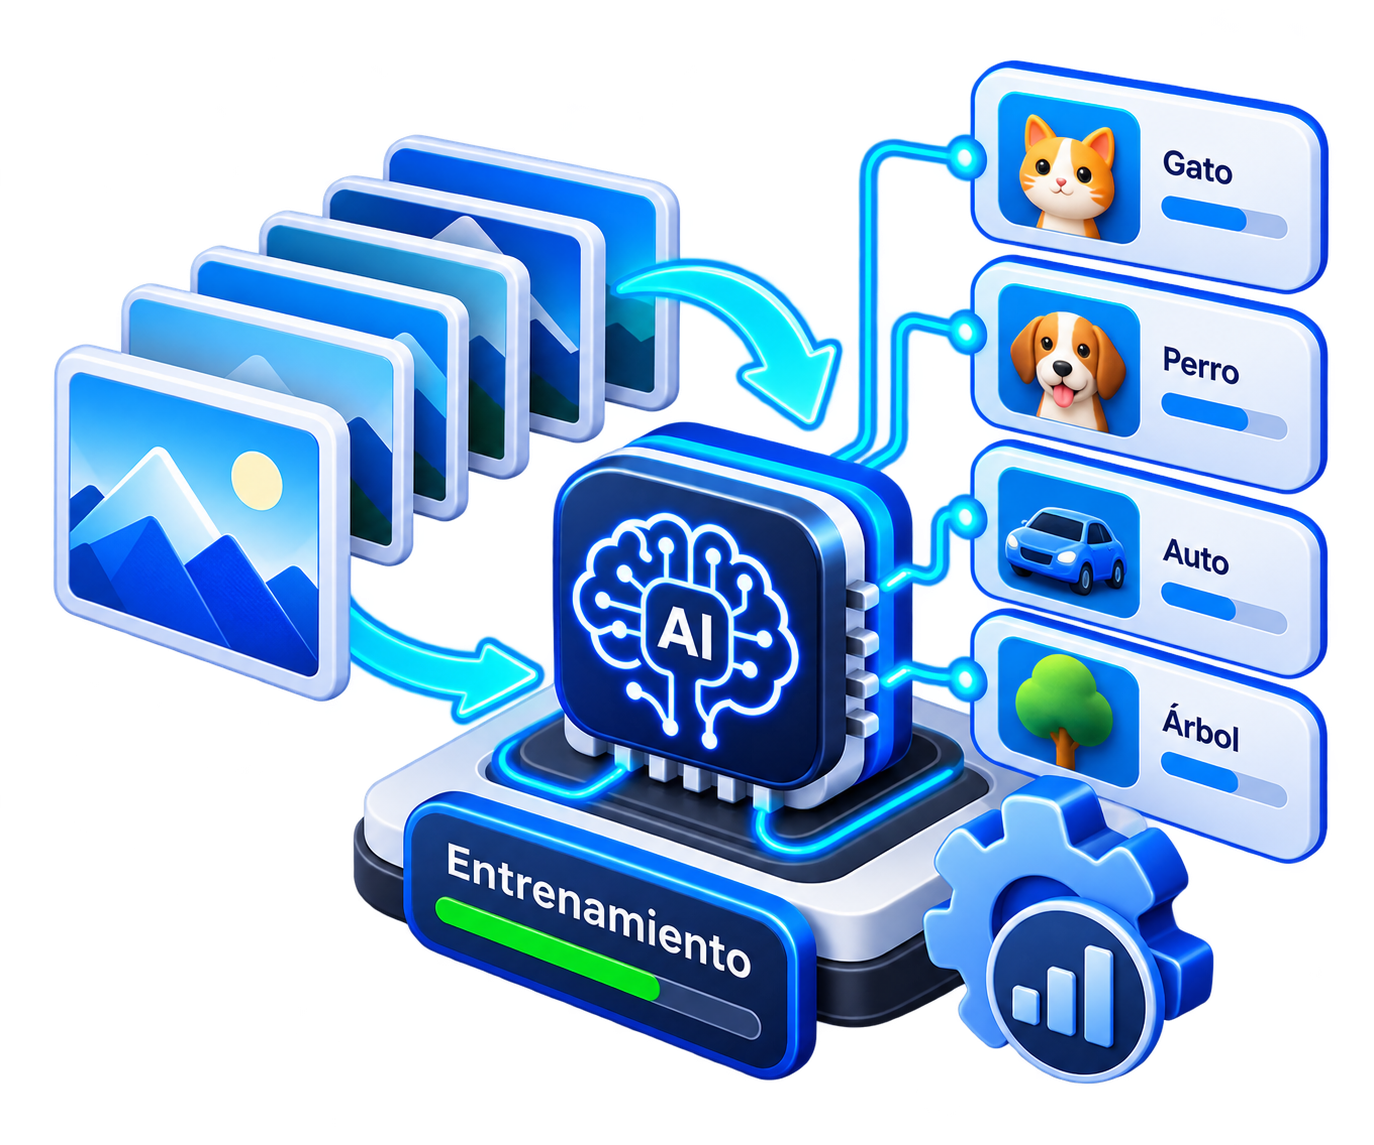
Nuestra tecnología basada en Deep Learning permite transformar grandes volúmenes de contenido visual en información inteligente mediante Operator Red para aprender, identificar y clasificar patrones complejos de forma automatizada.
Redav Vision Pixel identifica secuencias de imágenes JPEG generadas a partir de una transmisión multimedia. Esto permite detectar eventos relevantes, clasificar contenido, reconocer patrones y localizar el momento exacto en el que aparece un elemento dentro de una secuencia de video.
La tecnología facilita una red neuronal operativa para una operación inteligente, y análisis avanzado, reduciendo la intervención manual y acelerando la identificación de información relevante.
Los red neuronal pueden ejecutarse en la nube, en infraestructura híbrida o de forma local mediante una implementación On-Premise, proporcionando flexibilidad operativa, control de infraestructura eficiente para operar grandes volúmenes de imagenes.
Redav Vision Pixel puede adaptarse a diferentes modelos, categorías y escenarios mediante entrenamiento especializado sobre los elementos que cada proyecto necesita reconocer.
Generar desde cualquier fuente multimedia grandes volúmenes de frames JPEG para generar modelos de entrenamiento y ser analizadas por Operator Red Learning.
Clasifica imágenes dentro de categorías previamente definidas para definir los modelos de entrenamiento y Operator Red Learning consuma los modelos de aprendizaje definidos.
Consume los modelos de aprendizaje para identificar en grandes volúmenes de frames JPEG objetos y patrones, los resultados se integran en plataformas de analítica, sistemas internos o bases de datos.
Nuestros Operators IA permiten capturar, analizar y visualizar datos audiovisuales 24/7.
Conocer más →
Conoce la arquitectura de una Convolutional Neural Networks ::CNN.
Conocer más →