Audio y Video
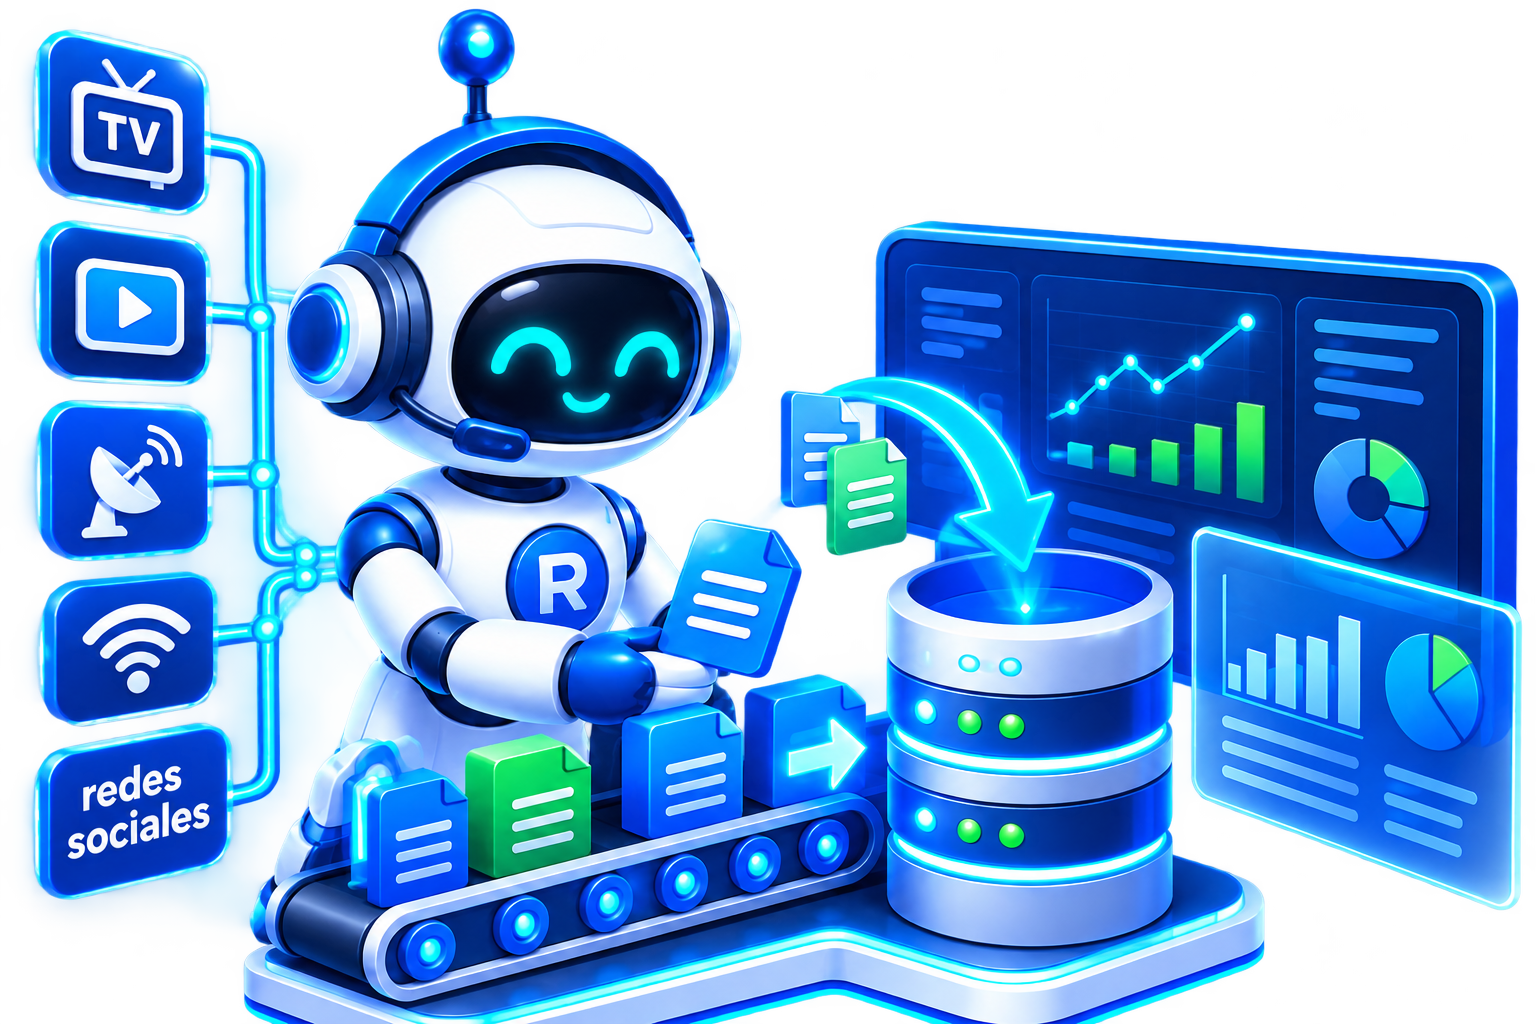
Opera con archivos multimedia provenientes de diferentes fuentes para identificar y extraer automáticamente el contenido hablado.
 Solicitar información →
Inteligencia artificial aplicada al reconocimiento de voz y contenido hablado. Redav Speech permite transformar archivos de audio y video en información textual estructurada mediante tecnologías de reconocimiento automático de voz, facilitando la transcripción, búsqueda, clasificación e integración de contenido audiovisual.
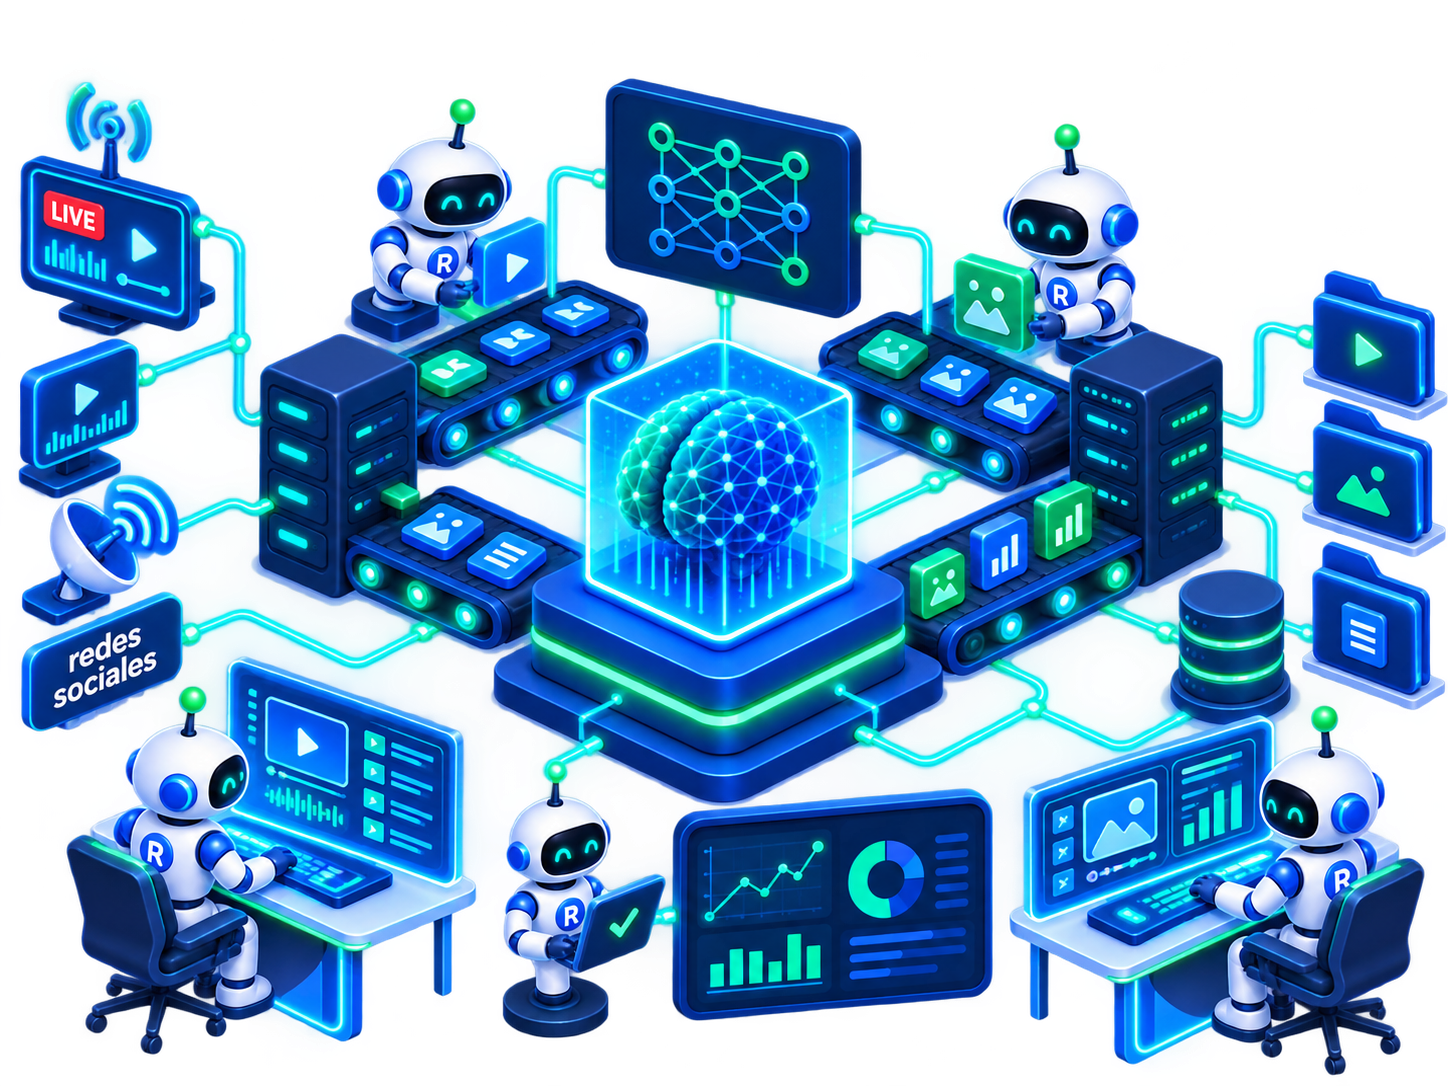
Redav Speech utiliza modelos de inteligencia artificial especializados en reconocimiento automático del habla para identificar palabras, frases y estructuras lingüísticas presentes dentro de archivos de audio y contenido audiovisual.
Las operaciones permiten convertir señales de voz en texto digital, generando información que puede utilizarse posteriormente para búsquedas, análisis, clasificación, indexación de contenido y automatización de operaciones.
La arquitectura está diseñada para operar con archivos individuales hasta grandes volúmenes de contenido, permitiendo integrar capacidades de Speech AI dentro de plataformas, sistemas internos, flujos de monitoreo y soluciones empresariales.
Representación conceptual del flujo de análisis y transcripción mediante Redav Speech.
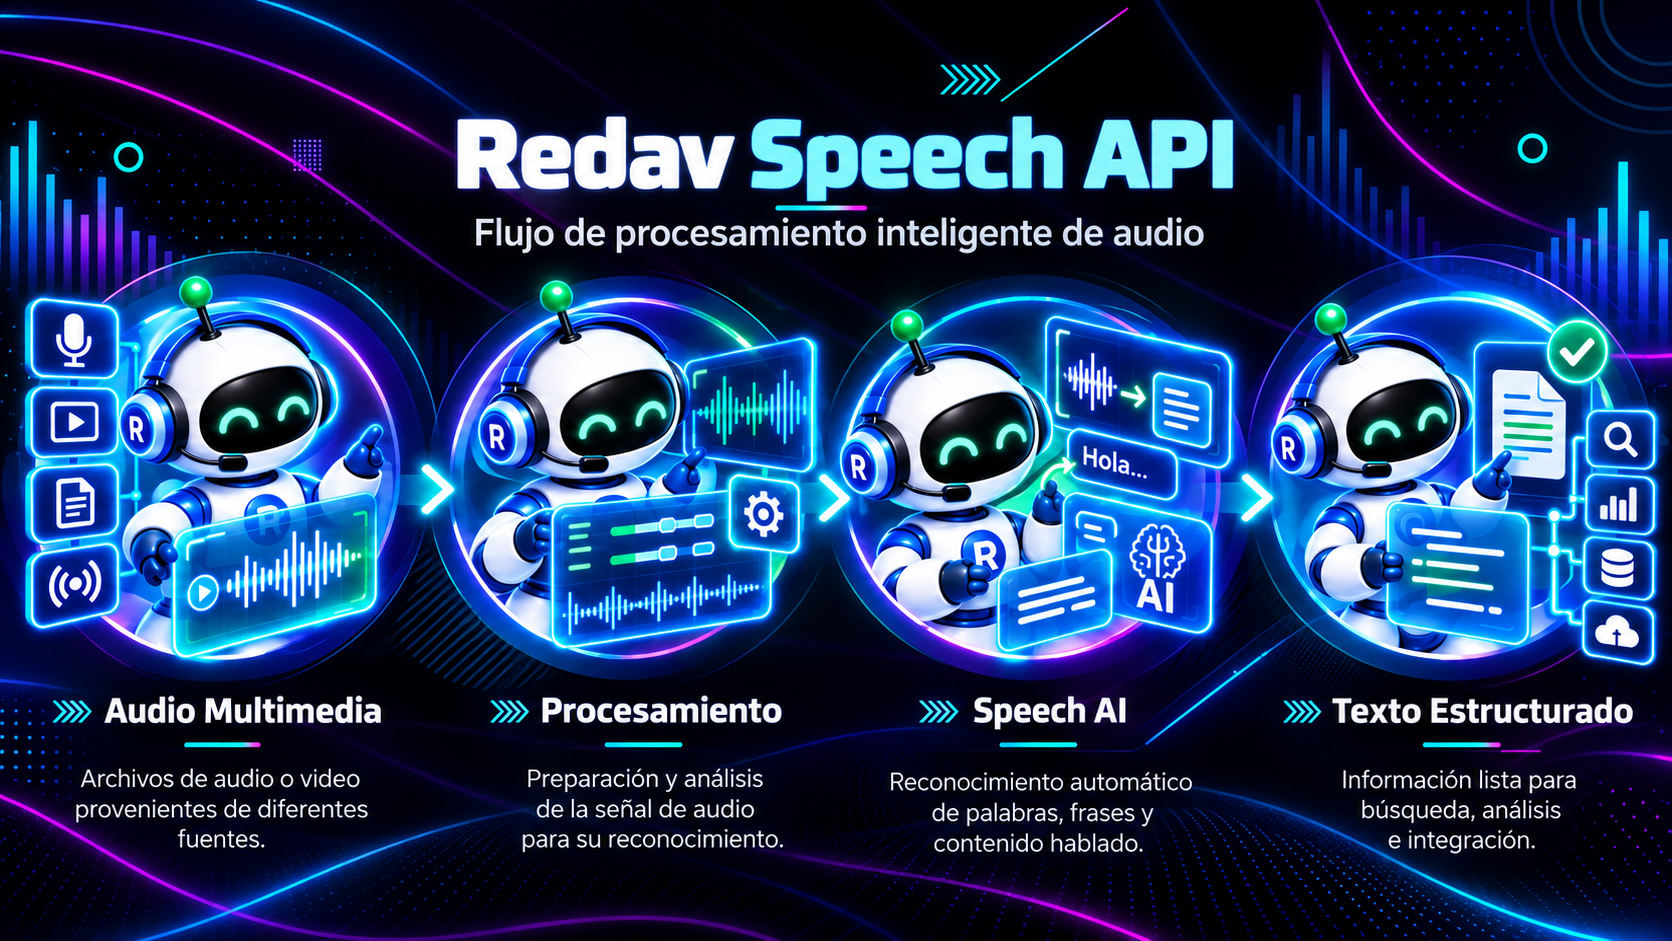
Redav Speech transforma contenido hablado en texto utilizando modelos de inteligencia artificial especializados en reconocimiento automático de voz, permitiendo automatizar operaciones de transcripción y extracción de información.
La API puede operar con archivos de audio y video provenientes de diferentes fuentes multimedia, identificando el contenido hablado y convirtiéndolo en información textual que puede almacenarse, consultarse o integrarse dentro de otros sistemas.
Una vez generado el texto, la información puede utilizarse para búsquedas de palabras clave, clasificación de contenido, indexación de archivos, generación de registros y operaciones posteriores de análisis mediante inteligencia artificial.
Redav Speech puede implementarse en arquitecturas Cloud, Hybrid u On-Premise, proporcionando flexibilidad para adaptar la capacidad de operaciones al volumen de audio y a los requerimientos operativos de cada proyecto.
Redav Speech API permite transformar grandes volúmenes de contenido hablado en información digital estructurada, facilitando su consulta, clasificación, almacenamiento e integración dentro de diferentes operaciones tecnológicas.
Opera con archivos multimedia provenientes de diferentes fuentes para identificar y extraer automáticamente el contenido hablado.
Convierte voz en texto mediante modelos de reconocimiento automático del habla, generando información digital utilizable para diferentes operaciones empresariales.
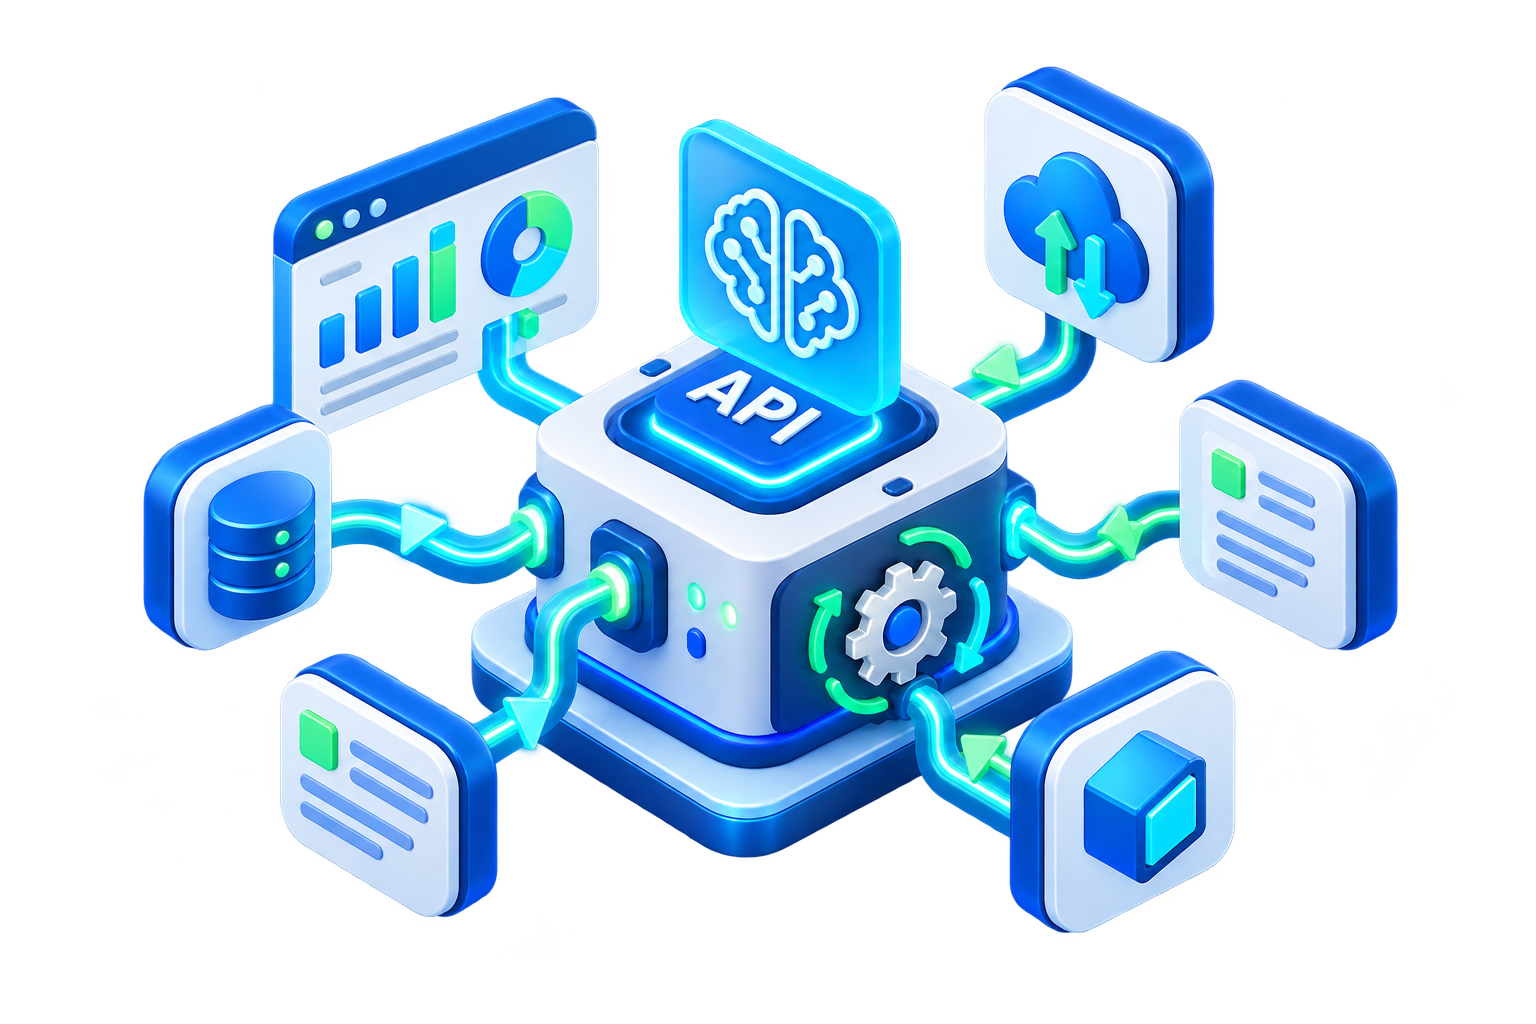
Los resultados pueden integrarse mediante API con bases de datos, dashboards, plataformas de monitoreo, motores de búsqueda, sistemas internos u operaciones posteriores de inteligencia artificial.
Nuestros Operators IA permiten capturar, analizar y visualizar datos audiovisuales 24/7.
Conocer más →
Conoce la arquitectura de una Convolutional Neural Networks ::CNN.
Conocer más →